STEP 01 / RAW
元の波形を見る
図のここ:半透明の波形の束。
読む:外れ値、群ごとの高さ、ピークの位置ずれ、波形の欠けを確認する。ここを飛ばすと、外れ値や前処理の影響をPCの意味だと誤読しやすい。
Functional data analysis / visual lecture note
Functional PCA(FPCA)は、時間に沿って並ぶ101点を別々の変数として眺めるだけでなく、一つの波形として扱い、波形同士の違いを少数の主成分関数へ圧縮する。
SOURCE NOTE 参照講義「functional PCA講義」と添付PDFをもとに再構成。下の6図はgpt-image2で生成した概念図で、測定値そのものではありません。
00 / orientation
直感から数式へ、数式から実装へ、最後に「その結果を信じてよいか」まで進む。迷ったら、いつでも3行の定義へ戻る。
01 / big picture
普通のPCAの「矢印」を、波形の時間軸へ戻して考える。両者の中心化は同じで、違いはデータをベクトルとして扱うか、関数として扱うかにある。
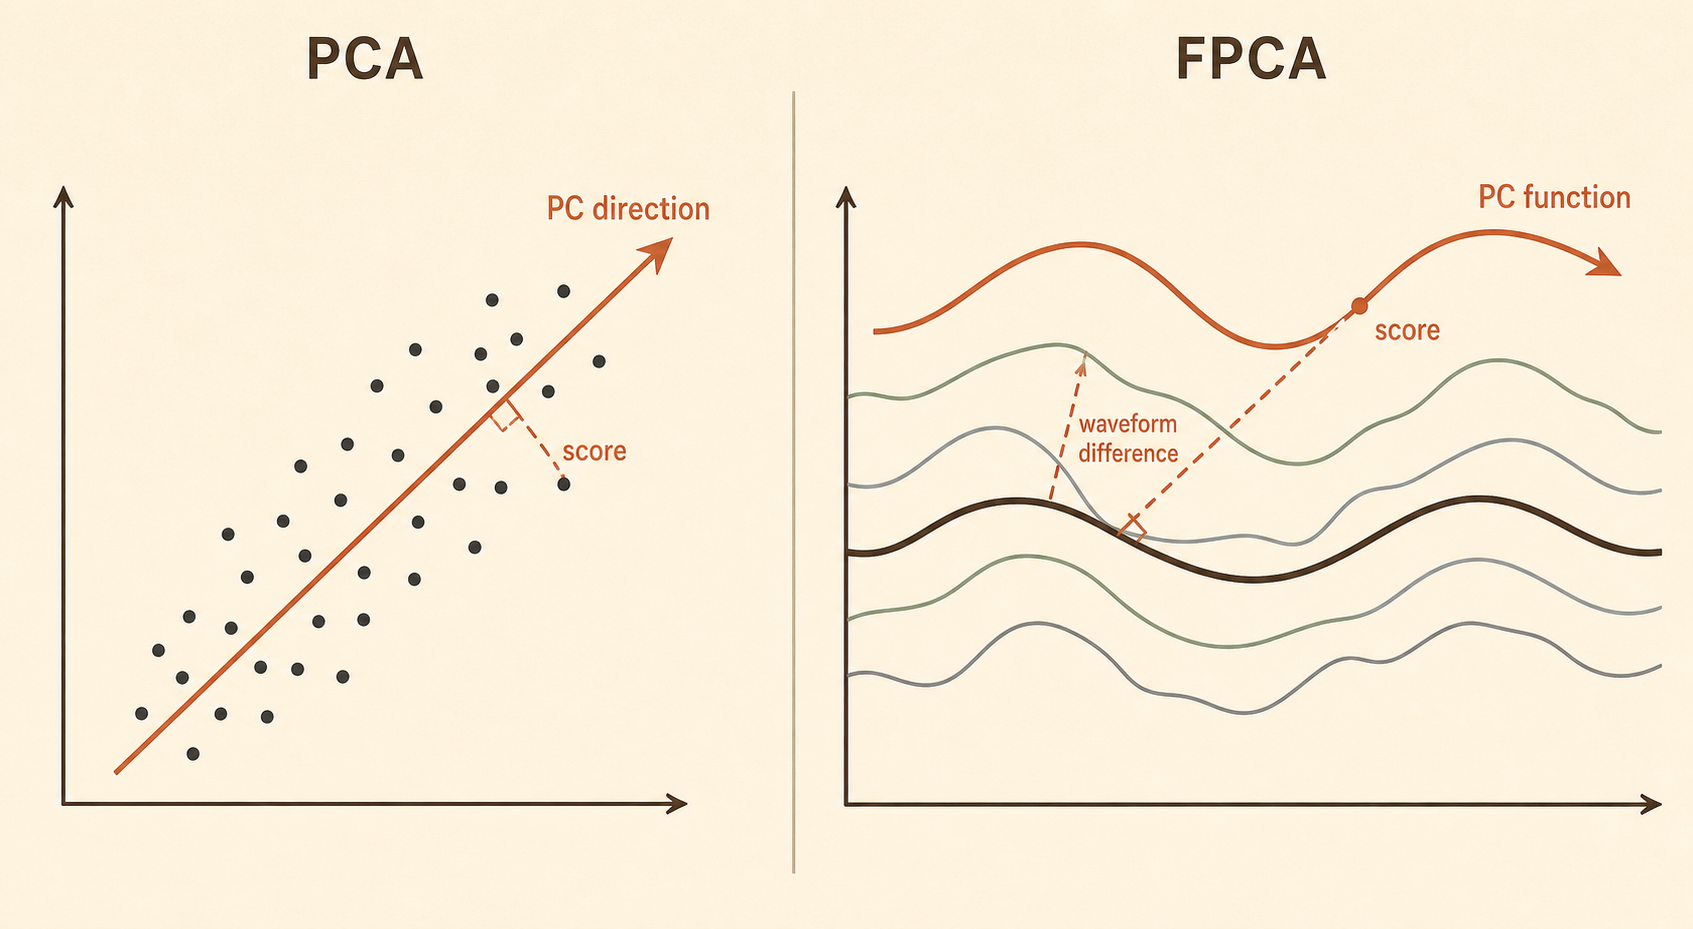
gpt-image2による概念図。説明用のイラストであり、特定データの推定結果ではない。
FPCAは、波形の変動を「共通の形」×「個人ごとの量」に分ける。
平均波形 μ(t) に、主成分関数 φk(t) を、対象者ごとのスコア ξik だけ足し引きする。
普通のPCAもFPCAも通常は平均を引いてから変動を分析する。「普通のPCAは生データ、FPCAは平均との差」という区別ではない。
| 観点 | 普通のPCA | FPCA |
|---|---|---|
| 入力 | p個の変数を持つベクトル | 時間 t に沿った波形 xi(t) |
| 主成分 | 主成分ベクトル vk | 主成分関数・固有関数 φk(t) |
| score | xiTvk | ∫[xi(t)−μ(t)]φk(t)dt |
| 読み方 | 変数の組み合わせ方向 | 波形がどの時間帯で、どう違うか |
02 / representation
101点は計算上の格子。FPCAが見たいのは点の列そのものではなく、その背後にある時間連続の変動である。
歩行1周期を0–100%に正規化し、101点で記録しても、1人のデータは「101個の無関係な測定値」ではない。隣り合う時点は連続した波形としてつながっている。
基底展開では、波形をB-splineやFourierなどの基底関数の組み合わせで近似する。基底展開とFPCAは別の処理であり、前者は表現、後者は変動の要約。
赤は一緒に上がる時間帯、緑は一方が上がると他方が下がる時間帯。対角線はその時点の分散を表す。
02+ / basis intuition
チャットで最もつまずきやすかった「basisって何?」「Gaussianのように無限に続く?」「サブグループ波形?」を、部品・局所性・係数の3段階でほどく。
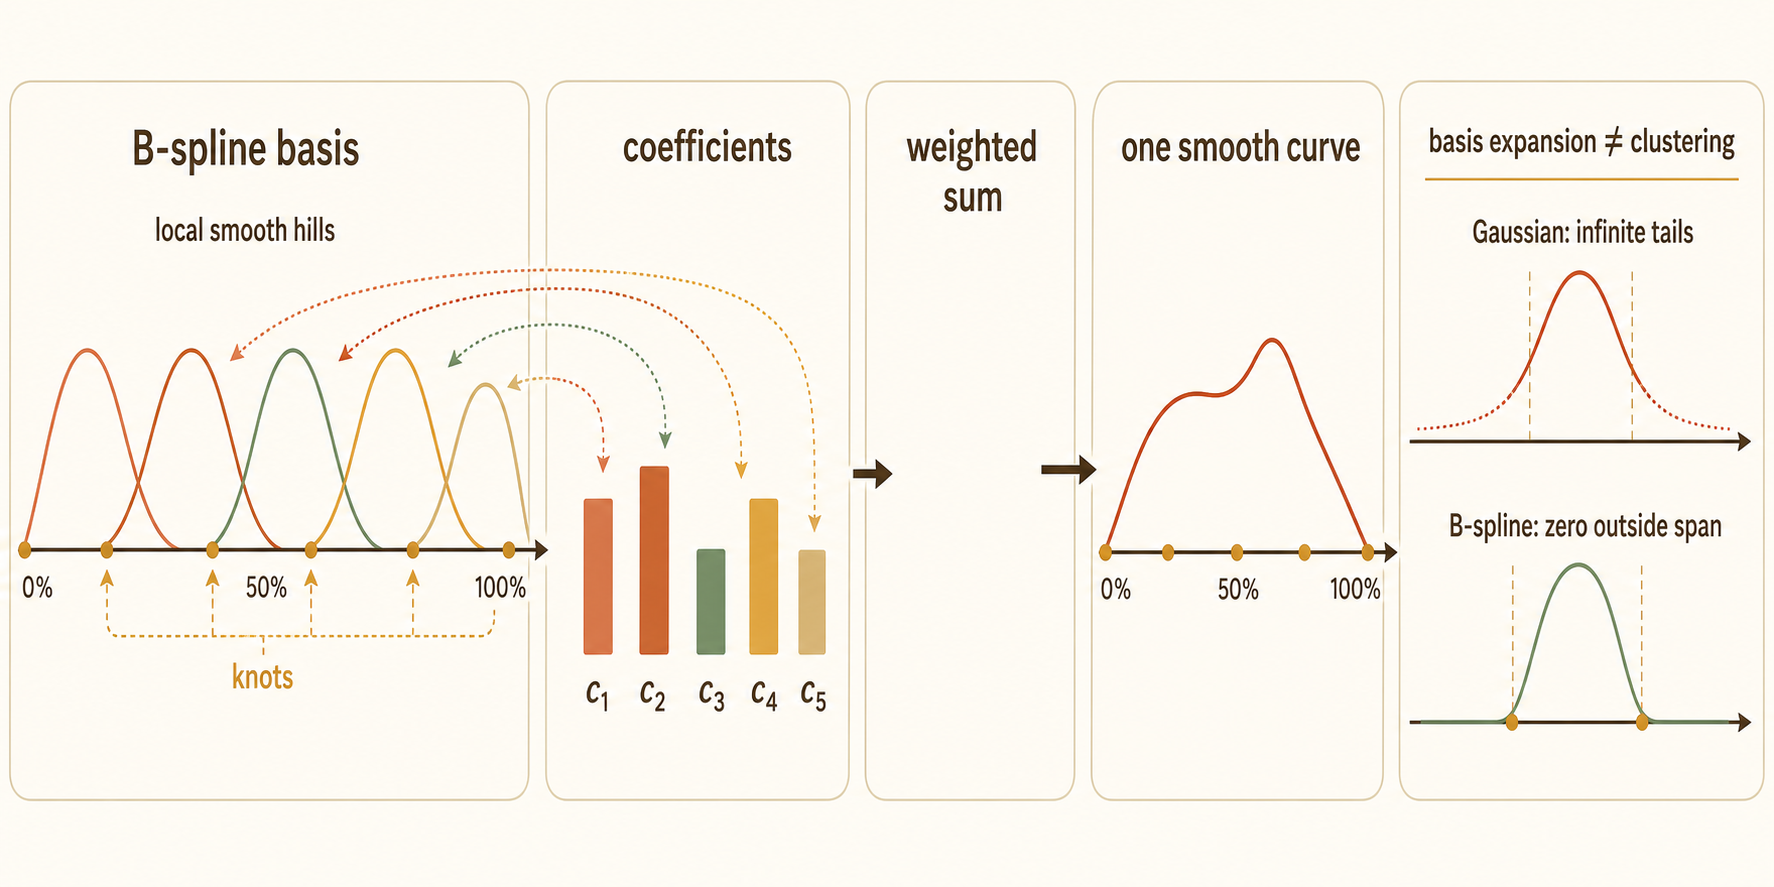
gpt-image2による教育用概念図。図中の曲線・係数は仕組みを示す模式表現で、測定データではない。
basis functionは、被験者を分けたサブグループの代表波形ではない。1本の波形を表現するための、再利用できる部品となる曲線である。
係数 cim は「被験者 i の波形を作るために、部品 Bm をどれくらい使うか」。
下の小山はそれぞれの担当範囲を持ち、範囲外では厳密に0になる。
cubic B-splineなら、角ばった三角形ではなく、隣と重なりながら滑らかな曲線になる。
立脚初期だけ、ピーク付近だけ、という局所変化を表現しやすい。範囲外は完全に0。
ノットは小山の区切りや重なり方を決める軸上の点。基底の形と局所範囲を左右する。
各部品に係数を掛けて足す。係数が大きい区間ほど、完成波形に強く表れる。
「端が降りても無限に続くガウス関数みたいなもの?」への答えは、似ているが違う。
B-splineの小山が横一列に少しずつ重なるから、全体として滑らかな波形を作れる。
各被験者の係数を平均すれば、平均波形の係数になります。さらに、
つまりbasis-based FPCAは、係数の平均からのズレを材料に、主要な波形差を探すとも言える。
| もの | 役割 | たとえるなら |
|---|---|---|
| basis function | 1本の波形を作る部品 | 小さな曲線パーツ |
| FPCA | 被験者間の主要な波形差を探す | 変動の軸を見つける分析 |
| cluster | 被験者を波形タイプごとに分ける | 似た人を同じグループにする処理 |
必ずしもそうではない。B-spline basis同士は一般に直交しないため、本格的なbasis FPCAでは、
というGram行列を考慮する。格子上の101点が揃っているならgrid-based FPCAで十分な場合もあるが、ノイズ・不均一な時刻・欠測があるとbasis表現が有用になる。
03 / covariance
「時間sのズレ」と「時間tのズレ」が、対象者間で同じ方向に出るか、逆方向に出るかを集約したもの。
mean function
時間ごとの平均をつないだもの。まずは「典型的な波形」を置く。
covariance function
2つの時点のズレの連動。C(t,t) はその時点の分散。
sampled matrix
101点にサンプリングすれば、連続関数の共分散を行列として近似できる。
共分散関数は「どの時間帯同士が一緒に動くか」の材料。そこから、変動を最もよく説明する波形パターン φ1(t), φ2(t), … を取り出す。
20%時点で平均より高い人は、30%時点でも高い傾向。2つの時間帯の偏差が同じ方向に動く。
20%時点で高い人は、70%時点では低い傾向。前半と後半のバランスやタイミング差が関わる可能性がある。
04–05 / eigenfunction & score
主成分関数とscoreはセット。片方だけ見ると、パターンの意味か個人差のどちらかを失う。
φk(t) は、波形の変動を表す共通パターン。λk は、そのパターン方向の分散。PC2はPC1と直交する。
対象者 i の波形が、その差分パターンをどの方向に、どの程度持つかを表す数値。
φ と −φ は同じ軸。scoreも同時に反転する。符号そのものではなく、関数とscoreの組として解釈する。
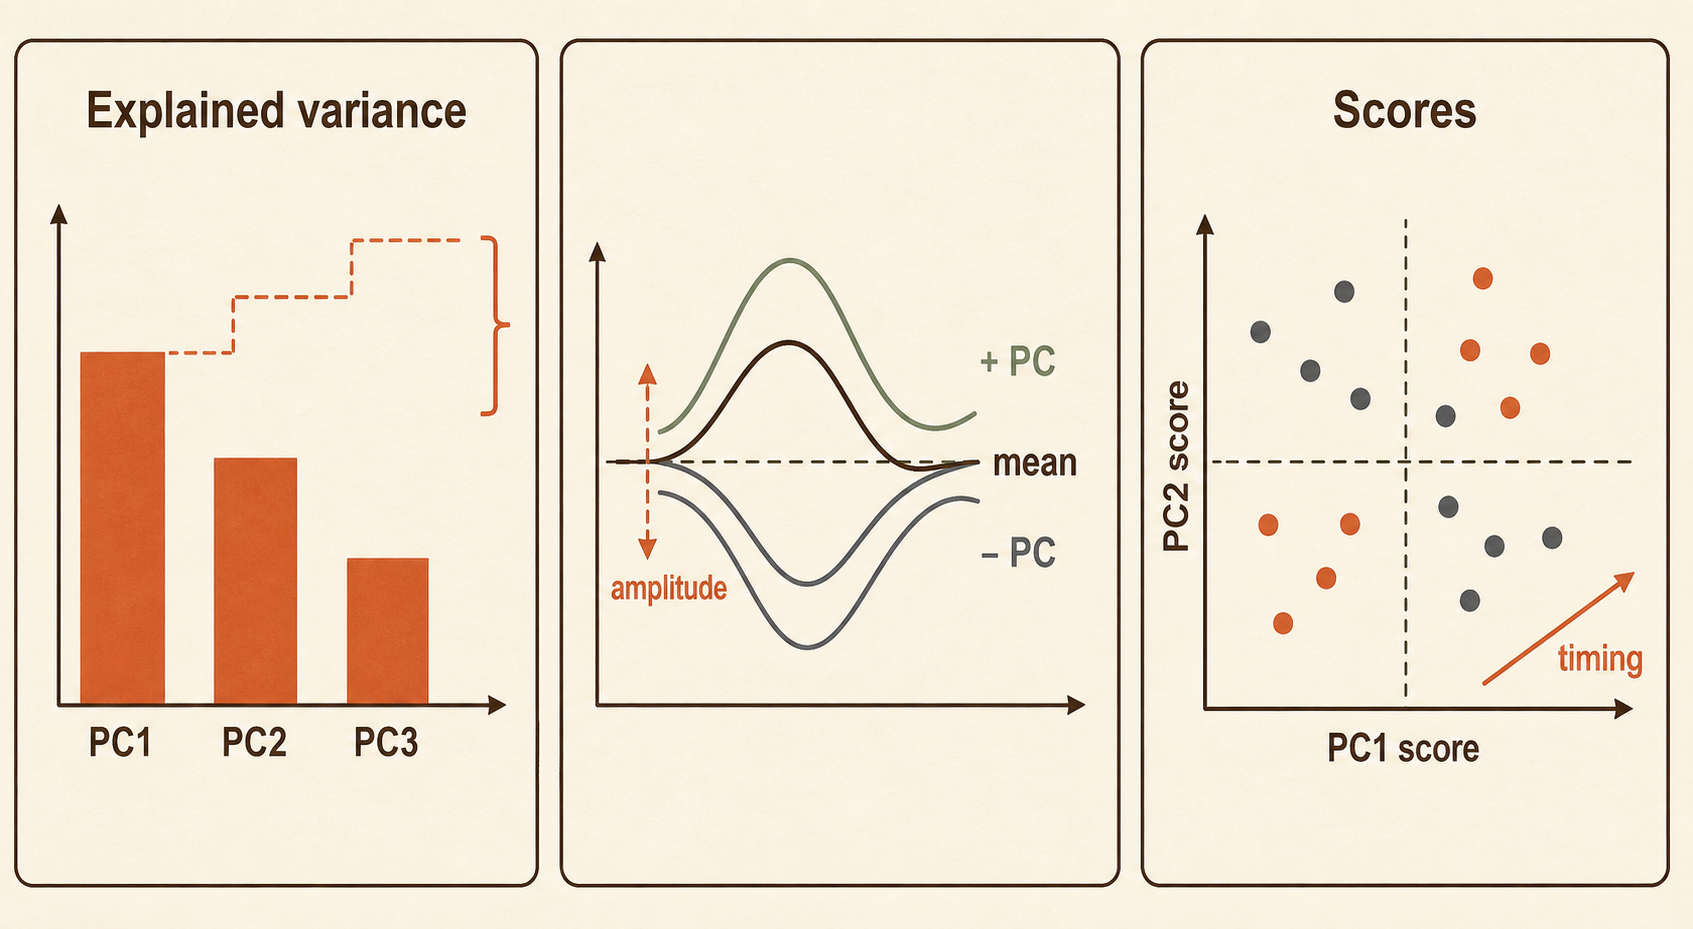
gpt-image2による概念図。下の論文の値や、本文の例示値を描いたものではない。
scoreの典型的な大きさを仮に置いて、平均波形からどの時間帯が上がる/下がるかを見る。PC関数の上下だけでなく、元の波形スケールに戻して読む。
共通の「差の形」。例:立脚初期が高く、後半が低い。
各対象者がその差をどれだけ持つか。正負で方向も変わる。
少数のscoreから、元の波形をどの程度戻せるか。
06 / implementation
格子上のFPCAは、中心化した波形行列に対するPCAとして実装できる。基底ベースでは内積行列の扱いが加わる。
import numpy as np

# X.shape = (n_subjects, n_timepoints)
mean_wave = X.mean(axis=0)
X_centered = X - mean_wave

# 101点の共分散行列
C = np.cov(X_centered, rowvar=False)

# 対称行列なので eigh を使う
eigvals, eigvecs = np.linalg.eigh(C)
order = np.argsort(eigvals)[::-1]
eigvals = eigvals[order]
Phi = eigvecs[:, order[:3]]

# 各対象者のPC score
scores = X_centered @ Phi

# 3成分で再構成
X_reconstructed = mean_wave + scores @ Phi.TX の行は対象者、列は時間。Phi の列がPC関数を離散化したもの。scores[i,k] が対象者 i のPCk scoreになる。
from skfda.representation.grid import FDataGrid
from skfda.preprocessing.dim_reduction import FPCA

fd = FDataGrid(data_matrix=X[..., None],
               grid_points=np.linspace(0, 1, X.shape[1]))
fpca = FPCA(n_components=3)
scores = fpca.fit_transform(fd)B-splineなどが互いに直交しない場合、通常の行列PCAをそのまま当てず、基底の内積(Gram)行列を含めて解く。
07 / interpretation
スコア散布図だけを先に見ない。まず具体的な波形とPC関数を確認し、それから群や個人の位置、最後に少数成分で何が残ったかを読む。
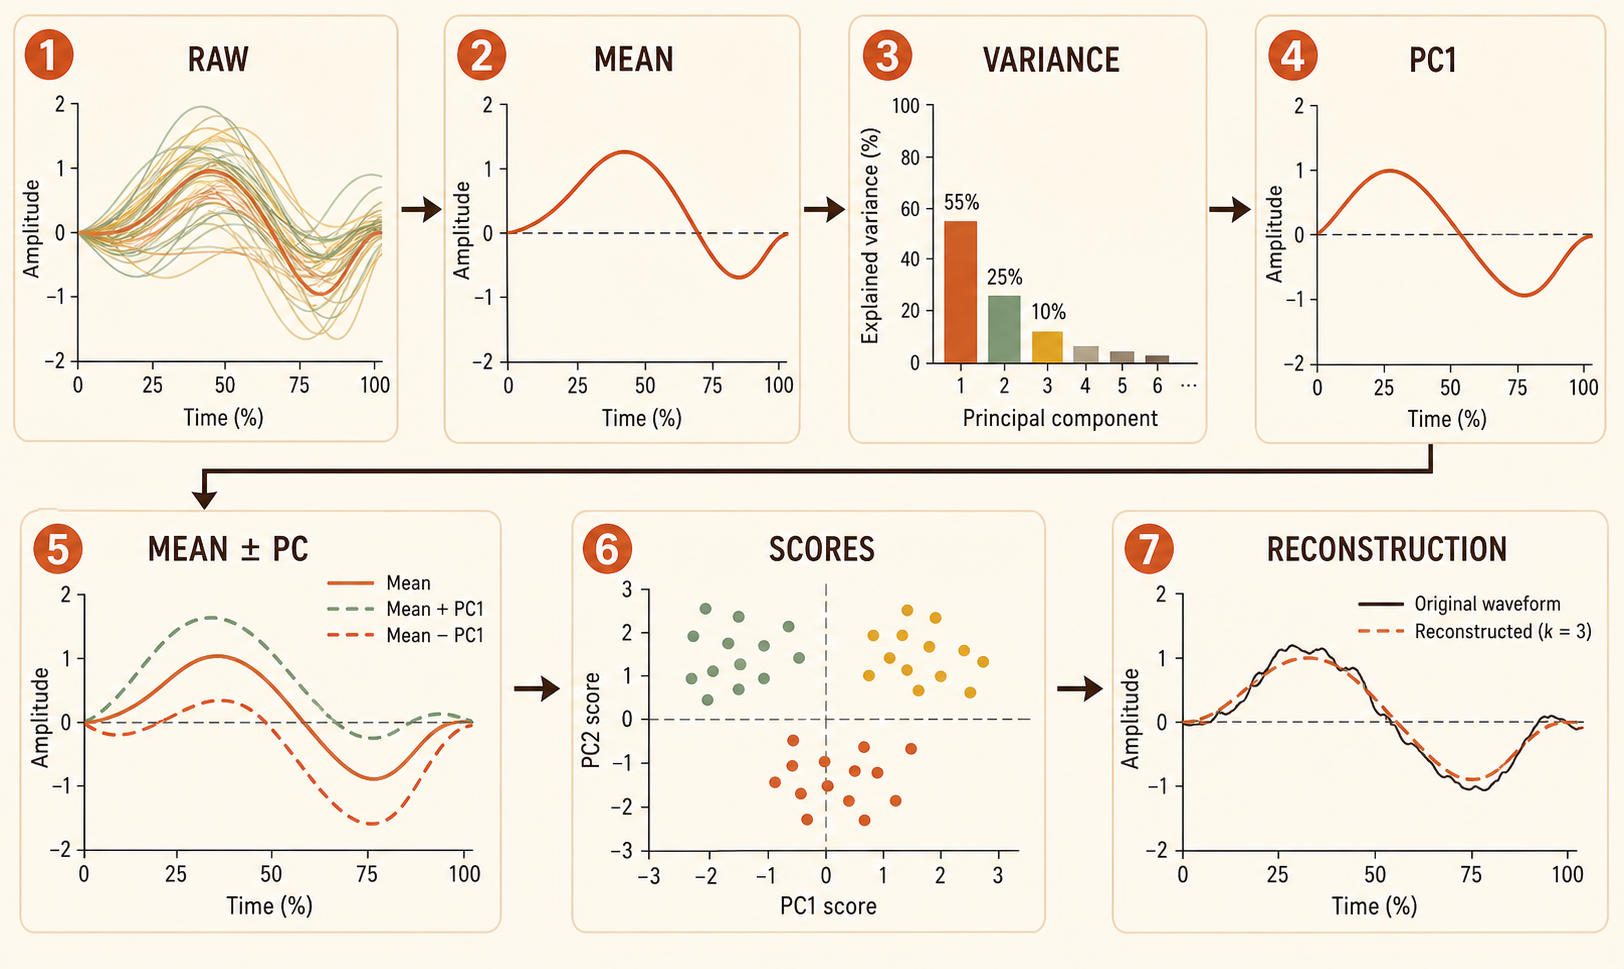
gpt-image2で作成した説明用の概念図。7つのグラフ、波形、scoreは読み方を示す例であり、添付論文や実測データの結果ではない。
STEP 01 / RAW
図のここ:半透明の波形の束。
読む:外れ値、群ごとの高さ、ピークの位置ずれ、波形の欠けを確認する。ここを飛ばすと、外れ値や前処理の影響をPCの意味だと誤読しやすい。
STEP 02 / MEAN
図のここ:全波形を代表する太い線。
読む:典型的なピーク、谷、立ち上がりの時期を確認する。後で見る「平均 ± PC」は、この平均からどのように変形するかを示す。
STEP 03 / VARIANCE
図のここ:PC1 55%、PC2 25%、PC3 10%という例示バー。
読む:3成分で90%を要約できるという候補を作る。ただし90%は合格証ではなく、再構成誤差・安定性・解釈可能性を続けて確認する。
STEP 04 / PC1
図のここ:0ラインをまたぐPC1の曲線。
読む:どの時間帯が同じ向きに動き、どこで符号が反転するかを見る。PC関数は共通の「差の形」であり、一人の波形そのものではない。
STEP 05 / MEAN ± PC
図のここ:平均線と、平均 + PC/平均 − PCの2本。
読む:PC1の正負が、平均波形をどの時期に上げ下げするかを確認する。振幅差かピークのタイミング差かは、この変形図で判断する。
STEP 06 / SCORES
図のここ:PC1 score × PC2 scoreの散布図。
読む:点の分離は「差がありそう」という仮説。群差を述べるなら、効果量や区間、共変量を確認し、点がどのPC関数の形に対応するかへ戻る。
STEP 07 / RECONSTRUCTION
図のここ:Original waveformと、k = 3で再構成した曲線。
読む:大きなピークや谷が残り、細かなノイズだけが落ちているかを見る。再構成誤差が大きいなら、PC数や平滑化、basis設定を見直す。
「まず元波形と平均で土台を確認し、説明分散で候補を作り、PC関数と平均 ± PCで差の形を波形へ戻し、scoreで対象者を位置づけ、再構成で要約が十分か確かめる」——この順番なら、score plotの見た目だけで結論を出さずに済む。
CHAT / stumbling points
ここは元の講義で実際に出てきた質問と、それに対する返答を再構成した章。読み飛ばさず、疑問が生まれた順番のまま置いてある。
大学みたいに第1講から全10講義で、1つ終わるごとに区切って質問したい——という進め方を土台に、講義本文と寄り道Q&Aを一つのノートへ統合した。
A. その理解で合っている。どちらもデータ全体の変動を、少数の主な変化パターンに要約する。
ただし、PC1は「正常」「代表」「原因」ではない。集めたデータの中で最も大きい変動方向であり、PC2はPC1と異なる変動を次に大きく説明する方向。FPCAでは、その方向が波形 φk(t) として表れる。
A. かなり近い。身長と体重が一緒に増えるなら、点は右上がりに細長く並び、 [+,+] に近いPC方向が出る。逆に、身長が高いほど体重が軽いなら [+,-] に近くなる。
ただしPCAが直接最大化するのは相関ではなく、新しい軸へ投影した値の分散。共分散行列を使えば変動幅も効き、相関行列を使えば標準化後の「一緒に動く向き」に近くなる。FPCAでは、この考え方が時刻間の共分散へ移る。
A. 論文のイメージは、各strideを [x(0), x(1), …, x(100)] という101次元ベクトルにし、0%のEMG、1%のEMG、…、100%のEMGを軸として扱うこと。
ただし、FPCAだけが平均からの偏差を使うわけではない。標準的なPCAも通常は中心化する。違いの本質は、101個の離散変数として扱うか、時間連続の関数としてモデル化するか。また論文は XTX を使い、中心化の明記がないため、PP1は全体形状を含みうる。論文のPPを中心化FPCAの固有関数と同一視しない。
| 比較 | 論文のwaveform PCA | 講義のFPCA |
|---|---|---|
| 軸 | 101個の時刻 | 連続時間の関数 |
| 中心化 | 方法節で明記されない | 通常 xi(t)−μ(t) |
| 主成分 | principal pattern(PP) | 固有関数 φk(t) |
A. 理論上はほぼその通り。101点の普通のPCAは101次元だが、FPCAでは x(t) という関数全体をデータとみなすので、0.1%、37.264%のような全ての時点を考える無限次元空間になる。
実際の計算では、101点の格子で近似するか、B-splineなどの有限個のbasis係数へ落とす。だから「理論は無限次元、計算は有限次元」という二層で理解する。
A. 「サブグループ」ではなく、部品となる波形を係数つきで足し合わせること。被験者をクラスタに分け、その代表波形を混ぜるわけではない。
basisは波形を表現する部品、clusterは被験者を分けるグループ。FPCAは、basisで表現された波形の間にある主要な変動軸を探す。
A. basis-based FPCAならそうなる。各波形をbasisで表すと、平均波形は係数の平均で同じbasisを合成したもの。
そのため、平均からの偏差も係数の偏差に置き換えられる。
A. 横にずらして並べた、滑らかな小さな山。cubic B-splineなら角ばった三角形ではなく、隣の山と重なりながら局所的な盛り上がりを作る。
例えば立脚初期だけ盛り上がる、ピーク周辺だけ形を変える、遊脚期だけ活動が残る、といった局所的な変化に向いている。図の「knots」は山の配置場所と重なり方を決める点。
A. 似ているが重要な違いがある。Gaussianは理論上、裾がどこまでも続いて完全な0にはならない。一方、B-splineは担当区間の外では厳密に0になる。
この局所性と、隣り合うbasisの重なりが、滑らかさと局所的な表現力を両立させる。
A. 「固有関数がプラスだから必ず平均より高い」ではなく、scoreも正の対象者では、その時刻を平均より上へ動かす成分になるという意味。
φk(t) が正でも ξik が負なら、積は負。ピークが時間的にずれるだけでも、前の時刻では一方が高く、後の時刻では逆になるため、PC関数にピーク前+/ピーク後−の符号反転が現れる。
振幅差かtiming差かは、固有関数だけで断定せず、 μ(t)±aφ(t) を描いて平均波形がどう変形するかで確かめる。
A. 普通のPCAでは、PCベクトルは「データが最もよく散らばる方向を示す矢印」。点をその矢印へ投影した位置がPC score。
FPCAでは矢印が波形になり、PC関数は「どんな波形変化か」、PC scoreは「その人がその変化をどれくらい持つか」。
A. できる。ただしFPCAの元データ空間は波形空間なので、同じ2次元散布図をそのまま描くのではなく、役割を分ける。
このノートの「PCAからFPCAへ」図がその橋渡し。右側の波形は理解用の概念図であり、実データの推定グラフではない。
A. 基本的に群間比較するのは、共通のPC関数へ投影した各対象者のscore。PC関数は集団全体から得た「違いの物差し」なので、誰がその物差し上で離れているかをscoreで比較する。
ただしscore差だけでは意味が分からない。PC関数と平均±PCを見て、「どの時間帯の波形が、どちら向きに違うか」へ戻す。
A. そのまま引くのは危険。beforeとafterで別々にFPCAすると、PC1の向きや意味が変わる可能性がある。
前後を比較するなら全期間を使った共通のFPCA空間へ両方を投影するか、先に差分波形 Δxi(t)=after−before を作って、その変化波形へFPCAする。
A. 見た目の分離は仮説。統計的・臨床的な意味を保証しない。scoreを目的変数として適切なモデル、効果量、区間、共変量を検討する。
また、PC1は正常・最適・原因ではなく、そのデータで最も多い変動方向。scoreと歩行速度の相関も、それだけで因果関係を意味しない。FPCAはまずデータ構造を記述する方法である。
A. それだけでは決めない。scree plotと累積説明分散は候補を示す指標。再構成誤差、PCの安定性、解釈可能性、平滑化・basis数・外れ値への感度を合わせる。
固有値が近いとPCの順位や形が入れ替わりやすい。bootstrapは不確実性を調べるが、サンプル数や外部妥当性を増やすものではない。
A. できる。101点の波形を、例えば [ξ1,ξ2,ξ3] という低次元特徴量にして、波形タイプの探索へ使える。
ただし、クラスタ数・距離・標準化・再現性を検討し、各クラスタの平均波形へ戻って、「本当に違う波形タイプか」を確認する。FPCAはクラスタそのものではなく、クラスタリング前の冗長性を減らす表現でもある。
CHECK / four choices
前半は元のチャットで実際に立ち止まった疑問、後半はFPCAを深く理解しているかを確かめる問題。各問で一つ選び、「答えを確認」を押すと理由が表示される。
正解の記号を覚えるより、解説を読んで「元の波形では何が起きているか」まで言い直してみる。特にQ14〜Q20は、実装と研究解釈をつなぐ問題。
正解 0/32 · 回答済み 0/32どちらもデータ全体の変動を少数の軸へ圧縮する方法。ただしPC1は「正常」「代表」「原因」ではなく、集めたデータで最も分散が大きい方向。
BPCAが直接最大化するのは相関ではなく、軸へ投影した値の分散。共分散行列なら変数のスケールも含み、相関行列なら標準化後の一緒に動く向きに近づく。
C標準的なPCAも通常は中心化する。論文は各strideを101次元ベクトルとして扱う近縁のwaveform PCAで、方法節に中心化が明記されない点もFPCAと同一視しない理由になる。
B関数は連続時間の全体を持つため理論上は無限次元。実装では101点の離散近似、またはB-splineなどの有限個のbasisで表すので、理論と計算を二層で区別する。
Abasisは波形を表現する数学的な部品、clusterは被験者を分けるグループ。basis展開は xᵢ(t) ≈ Σ cᵢₘBₘ(t) のように、係数を変えて個々の波形を作る。
DGaussianは理論上0に到達せず、B-splineはcompact supportを持つ。局所的にだけ効くB-splineを少しずつ重ねることで、滑らかさと局所的な調整を両立できる。
C再構成は xᵢ(t) ≈ μ(t)+ξᵢₖφₖ(t)。φが正でもscoreが負なら積は負になるので、固有関数だけで「平均より高い」と断定しない。
B普通のPCAの矢印と投影位置の対応を、波形へ移したもの。PC関数が差の形を示し、scoreが個人をその方向へどれだけ投影したかを示す。
A全員のbasis係数を平均すれば、平均波形の係数になる。中心化した曲線も xᵢ(t)−μ(t)=Σ(cᵢₘ−c̄ₘ)Bₘ(t) と同じbasisで表せる。
CFPCAの元データ空間は波形空間なので、通常PCAの点の雲をそのまま置き換えるのではなく、平均波形、μ±aφ、対象者のscoreという役割で橋渡しする。
DC(s,t)は中心化した波形の偏差どうしの共変動。正なら同じ向き、負なら逆向きに動く傾向を表すが、時間的な因果関係ではない。
B固有値はその方向にどれだけデータが散らばるかを表す。大きいから臨床的に重要、正常、原因という意味ではなく、説明分散と解釈を組み合わせる。
Cξφの積が同じなら、φとscoreを同時に−1倍しても再構成は変わらない。群差を解釈するときは、ソフトウェア間の符号ではなく、実際のμ±aφとscoreの対応を見る。
Ascoreは、中心化した個人波形がPC関数方向へどれだけ投影されるかを示す内積。離散データでは時間間隔や数値積分の重みも考慮する。
D90%や95%は候補を作る目安であって、妥当性の保証ではない。固有値が近い場合の順位交換、LOOやbootstrap、再構成、感度分析、説明のしやすさを一緒に見る。
B別々に学習したPC軸は、向きや意味が変わりうるためscoreを直接比較できない。共通空間か差分波形を使えば、「同じ物差しで変化を測る」設計になる。
Cベクトルの内積では直交座標を前提にしやすいが、basis展開の係数空間では関数の内積がGで重みづけされる。これを無視すると直交性や分散の計算を誤る。
A時間点が多くても、同じ波形内の観測を独立な被験者として数えられない。nが小さければPCの形や群差の推定が不安定になりうる。
Dx̂ᵢ(t)=μ(t)+Σₖ₌₁ᴷξᵢₖφₖ(t)は、選んだK個の変動パターンで元波形を近似する式。再構成誤差を見れば、圧縮で何を捨てたか確認できる。
Bscoreは差の量を知らせるが、意味はφ(t)とμ(t)へ戻して読む。どの時期の振幅やタイミングが違うかを示し、研究デザインと交絡を踏まえて関連として解釈する。
C第1章のQ01〜Q20で14問以上に正解し、Q14のscore式、Q15のPC数選択、Q16の前後比較、Q20の「scoreから波形へ戻る」流れを自分の言葉で説明できれば、FPCAの計算だけでなく解釈の骨格までつかめている。
09 / application
添付論文は、股関節OAの重症度による歩行中の股関節運動と殿筋活動の違いを、101点の歩行周期へ要約した例。
Rutherford, Moreside, Wong. “Hip joint motion and gluteal muscle activation differences between healthy controls and those with varying degrees of hip osteoarthritis during walking.” DOI 10.1016/j.jelekin.2015.10.010
自己選択速度のトレッドミル歩行を、各参加者3回・各20秒収録。片側あたり40歩行周期超を取得し、重症OA群ではトレッドミル歩行ができずEMG解析から3人が除外された。
表面EMGを2000 Hzで収録し、20–500 Hz bandpass、60 Hzと高調波のnotch、整流、6 Hz lowpassで包絡化。歩行周期を0–100%の101点へ時間正規化した。
| 項目 | 論文で行ったこと | 解釈上の意味 |
|---|---|---|
| EMG | 20–500 Hz bandpass、notch、整流、6 Hz lowpass | 歩行周期の活動包絡を比較 |
| 正規化 | 各歩行周期のpeak EMGで振幅正規化 | 絶対振幅ではなく相対的な時間パターン |
| 行列 | stride × 101 | 1周期を同じ長さにそろえた波形データ |
| PCA | [S] = [XT][X]、90%以上を説明するPPを保持 | 論文の主成分パターン(PP)で波形を要約 |
本文ではGMdとGMxについて、3つのPPで合計98%の変動を説明すると報告。
この論文は波形にPCAを適用した近縁例。方法節に中心化が明記されず、XTX を用いているため、本文の「中心化したFPCA」と完全に同じではない。
したがって、PP1を必ず「平均からの差」と読むのではなく、論文の定義どおり、全体形状を含みうる主パターンとして読む。
paper / measured values
平均(標準偏差)。GMd = gluteus medius anterior、GMx = gluteus maximus。
股関節の総可動域。重症OAほど小さく、3群間で差。
重症群で高い。本文ではGMd PP1で重症群と他2群の差を報告(p<0.001)。
論文では早期〜中期立脚の低下を捉えるパターンとして解釈。
| 指標 | Healthy | Moderate OA | Severe OA | 読み方 |
|---|---|---|---|---|
| 矢状面 total ROM | 48° (5) | 40° (7) | 24° (8) | 重症群で大きく低下。健康群と中等度群の差も報告。 |
| 前額面 total ROM | 11° (3) | 10° (3) | 6° (2) | 重症群で低下。 |
| 水平面 total ROM | 18° (4) | 16° (4) | 11° (4) | 重症群で低下。 |
| Walking speed | 1.51 (0.16) | 1.32 (0.22) | 1.11 (0.27) | 3群で異なる。 |
| Stride length | 1.48 (0.12) | 1.34 (0.16) | 1.16 (0.17) | 3群で異なる。 |
| 筋 / PP | Healthy | Moderate OA | Severe OA | 論文中の読み方 |
|---|---|---|---|---|
| GMx PP1 | 399.5 (84.0) | 395.0 (118.2) | 462.6 (68.5) | 全体の主パターン |
| GMx PP2 | −42.3 (63.1) | −33.7 (102.3) | 26.4 (90.2) | 重症群と健康/無症候群で差(p=0.042) |
| GMx PP3 | −10.6 (64.4) | −5.5 (66.6) | 31.5 (80.9) | 本文では群差の中心ではない |
| GMd PP1 | 410.6 (63.2) | 436.6 (69.5) | 521.2 (98.6) | 重症群と他2群で差(p<0.001) |
| GMd PP2 | 62.0 (49.6) | 30.7 (59.9) | −55.5 (106.9) | 重症群と他2群で差(p<0.001) |
| GMd PP3 | 3.2 (60.2) | −3.1 (58.4) | −4.0 (57.6) | 中期〜後期立脚の差を表す候補 |
言えること:重症OA群では、股関節ROMが小さく、GMd・GMxの時間パターン要約値に差がある。言えないこと:peak正規化されたEMGから、絶対的な筋活動量や股関節圧縮荷重を直接比較すること。
さらに、健康群の画像診断がないこと、OA群の反対側に無症候性OAがありうること、トレッドミルが計装されていないことも限界として残る。
08 / validity
「少ない成分で90%を説明できた」は圧縮の結果。研究として信じられるかは、安定性・再現性・解釈・感度を合わせて判断する。
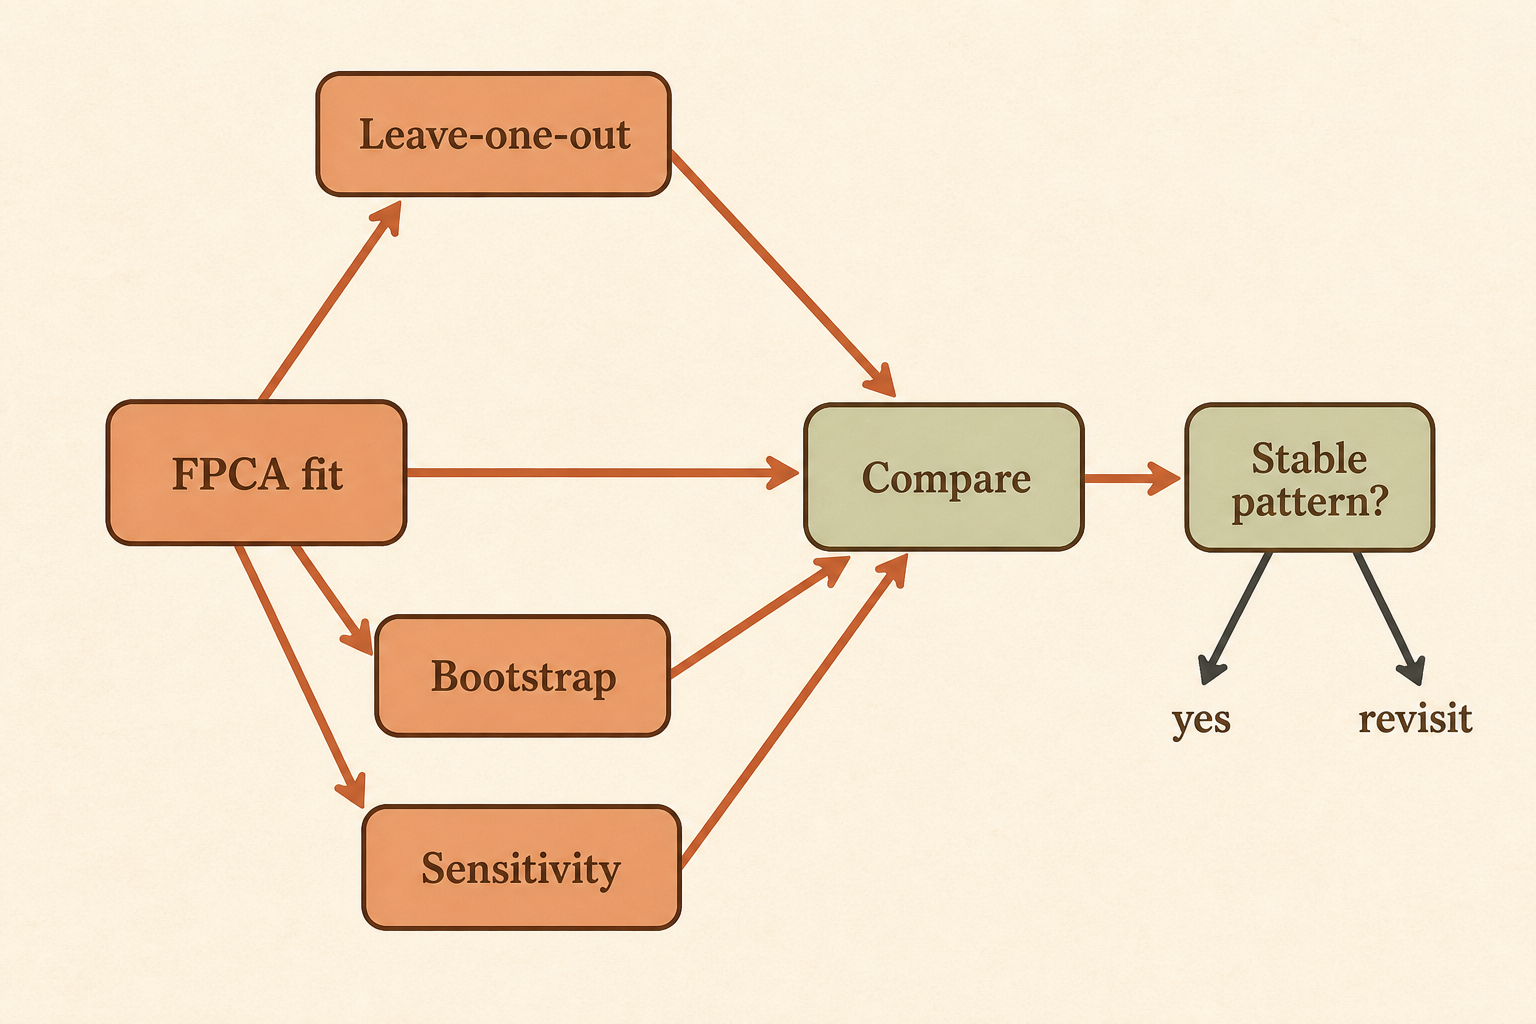
gpt-image2による概念図。検証結果を自動的に保証するものではない。
保持成分で元の波形の重要な特徴が戻るか。全体平均の誤差だけでなく、ピークや時間帯も見る。
1人ずつ外しても、固有関数の形・説明分散・scoreの群差が大きく変わらないか。
再標本化でPCの形とscoreの区間を評価。ただしサンプル数や外部妥当性を増やすものではない。
平滑化、基底数、時間正規化、EMG前処理、外れ値処理を変えて結論が残るか。
λが近いとPCの順位や形が入れ替わりやすい。軸の順番だけで強い主張をしない。
説明分散 + 再構成 + stability + interpretability + sensitivity。どれか一つの指標で「正しい成分数」を決めない。
時間点が多いことは、独立な情報が多いことと同じではない。隣接時点は連続した波形として相関しているため、対象者数 n が小さいなら、PCの安定性と外部妥当性を慎重に見る。
歩行全周期を一度にFPCAすれば全体の連動を、立脚・遊脚など局面ごとに分ければ局所的な差を捉えやすい。どちらが正しいかは研究質問と時間正規化の前提で決める。
10 / research workflow
計算を始める前に研究質問を固定し、最後はscoreの差を元の波形の時間帯へ戻して説明する。
「どの波形の違いを知りたいか」「群差か、個人差か」を明確にする。
筋、周期、時間正規化、平滑化、振幅正規化、外れ値基準を記録する。
FPCAの前に、データの質と時間ずれを可視化する。
共分散、固有関数、固有値、scoreを計算する。
説明分散だけでなく、再構成・解釈・安定性で決める。
PC関数、平均±PC、元データへの重ね描きで意味を固定する。
共通のPC空間で群、前後、クラスタを比較。複数筋ならMFPCAも検討。
LOO、bootstrap、感度分析を経て、結果・限界・一般化可能性を記述する。
before/afterを別々にFPCAへ入れると軸が変わる可能性がある。比較には共通PC空間を使うか、同一対象の差分波形 Δxi(t)=after−before を定義する。
EMGをpeakで正規化した場合、絶対振幅の群差は消える。PCの意味は「相対的な時間パターン」に寄る。
対象者数、波形の定義、時間軸、中心化、平滑化/基底、共分散の定義、成分数の基準、scoreの推定法、検証法、符号合わせ、外れ値処理。
平均波形、説明分散、PC関数、平均±PC、scoreの分布、再構成誤差、安定性、元の時間帯へ戻した解釈。
「PC2 scoreが高い」をそのまま生理学的意味にしない。score差 → 波形変化 → 生理学的な仮説の順に戻して書く。相関は関連であり、PCが原因だとは言わない。
筋ごとに別のFPCAをすると軸も別々になる。複数筋を一緒に扱うなら、各筋の波形構造を統合するMFPCAを検討し、どの筋・時間帯に寄与があるかを元波形で確認する。
CH01 / takeaways
FPCAは、次元削減のテクニックであると同時に、波形の変動を説明する言語でもある。
01
平均波形そのものではない。時間軸上の「違い方」を表す。
02
PC関数で表される差を、その対象者がどれほど持つか。
03
固有関数とscoreは同時に反転できる。組で読む。
04
再構成、LOO、bootstrap、感度、解釈可能性を確認する。
波形を、平均と少数の「違いの形」と、その人ごとのscoreへ分解する。だから、101点の波形を少数の数値で比較しながら、最後は元の時間軸へ戻って説明できる。
CHAPTER 02 / MFPCA
02 / multi-waveform
ここからは、Gmed・Gmaxのような複数筋を一つの分析空間へ置く。単独の筋の個人差ではなく、筋どうしがどんな組み合わせで変わるかを読む。
MFPCA(Multivariate Functional PCA)は、複数の関数をまとめた ベクトル値関数 にFPCAを行う方法。2筋なら「筋 × 時間」の空間に、1人のタスクを1点として置き、共同変動の軸を探す。
02.01 / core picture
1筋のFPCAで波形を1本の関数として見た。その関数が複数本になったら、同じ時刻の並びをまとめて一つのベクトル値関数として扱う。
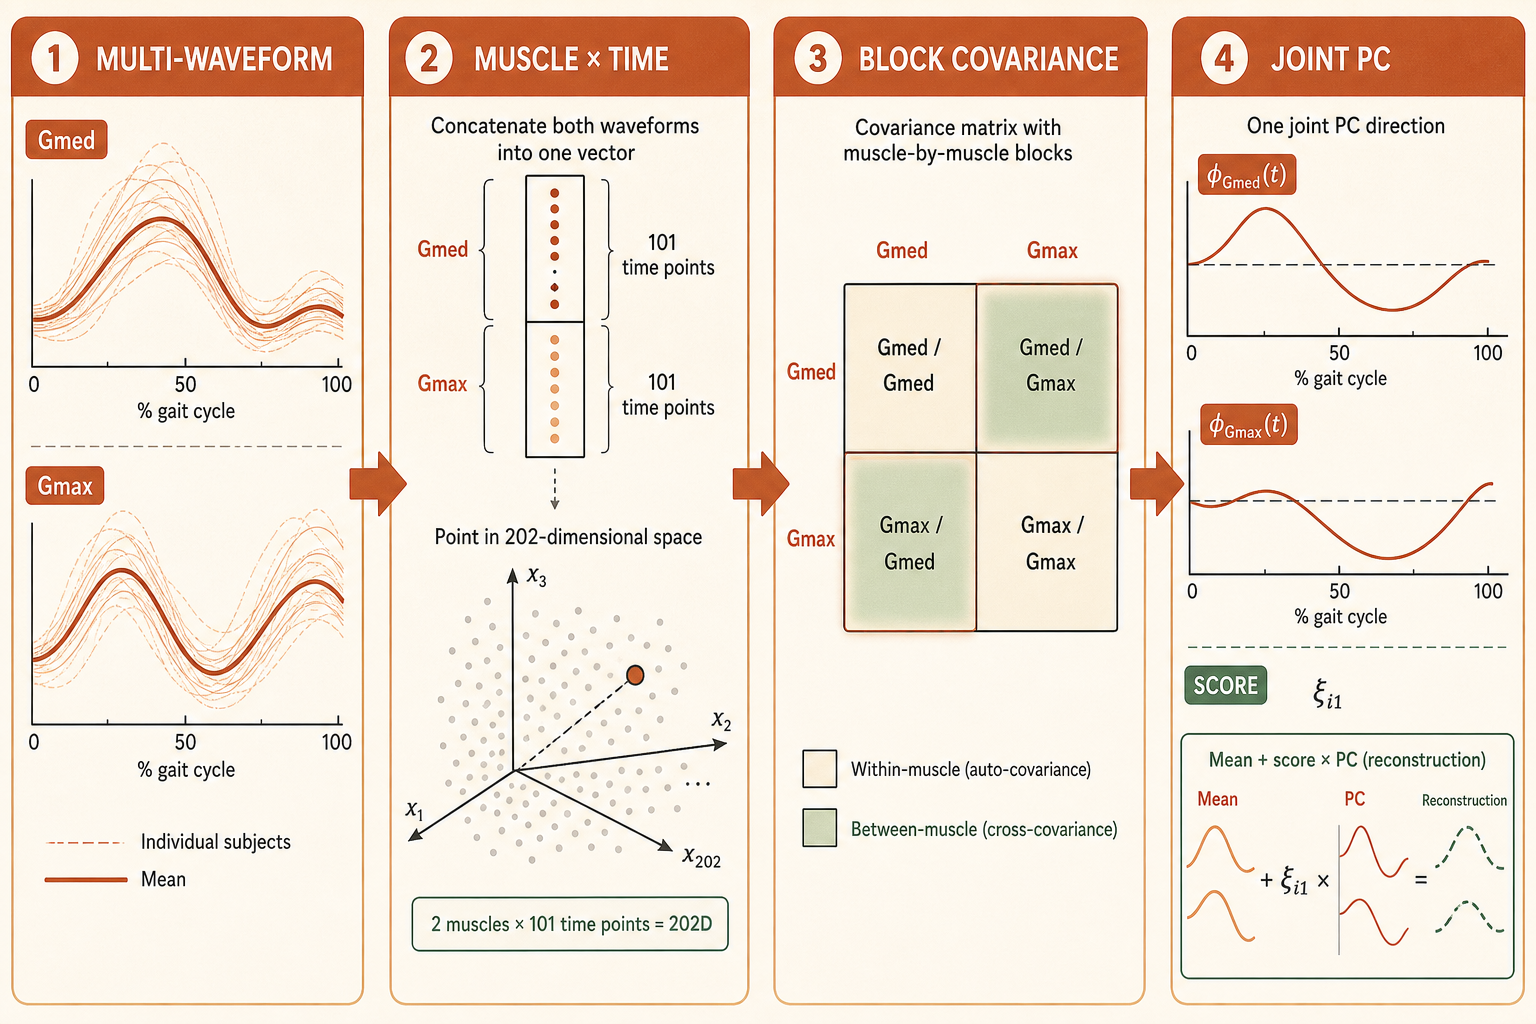
gpt-image2による教育用概念図。曲線、点、共分散ブロックは仕組みを示す模式表現で、測定値そのものではない。
被験者 i の1タスクは、次のような一つのベクトルになる。
視覚化しにくいが、これは「Gmedがこの形で、かつGmaxがこの形」という組み合わせ全体を表す1点。
1筋なら関数空間、2筋ならその直積空間。MFPCAは無限次元の概念を消すのではなく、複数の関数を束ねた 一つのベクトル値関数 として主成分方向を探す。
| 見ているもの | 1筋のFPCA | 複数筋のMFPCA |
|---|---|---|
| 1人の表現 | 1本の波形 xi(t) | 複数波形の組 xi(t) = [xi,Gmed(t), xi,Gmax(t)]T |
| 共分散 | 時間 × 時間 C(s,t) | (筋 × 時間) × (筋 × 時間) |
| PCの形 | 1本の固有関数 φk(t) | 筋ごとの関数を束ねた φ⃗k(t) |
| score | 1人 × 1筋 × PC | 1人 × 複数筋 × 共同PC |
| 新しく入る情報 | 筋の中の時間パターン | 筋間の共同変動(cross-covariance) |
02.02 / covariance
MFPCAの核心は、筋の中だけでなく、筋と筋のあいだの共変動を同じ共分散構造へ入れること。
各ブロックは101×101。全体は202×202の共分散行列になる。
「人によって、Gmedの時刻 s の偏差が大きいとき、Gmaxの時刻 t の偏差も大きい/小さい傾向があるか?」を聞く。
正なら同じ向き、負なら逆向きの 被験者間の共同変動。1人の中で先に起きた筋が後の筋を引き起こす、という因果や時間同期ではない。
p筋なら、筋ペアごとに p2 個の共分散面がある。ただし対称性 Cab(s,t)=Cba(t,s) がある。
だから、MFPCAは「筋ごとの結果を並べる」だけではなく、すべてのブロックを含む一つの共分散構造から共同軸を作る。
02.03 / joint direction
数学的には一つの固有方向。解釈するときはGmed部分、Gmax部分という複数の曲線をセットで読む。
Gmedでは立脚初期が+、Gmaxでは立脚後期が−、のように、複数筋の波形の組み合わせを一つの変動パターンとして表す。
各筋の寄与を足し合わせて、共同パターンへの投影量を1つの数値にする。高い/低いは、そのパターンの向きとセットで読む。
GmedのPC1とGmaxのPC1を別々に計算して、単純に「MFPCAのPC1」と呼ぶわけではない。共同空間で一つの固有方向を求め、その方向を筋ごとの成分へ分解して表示する。
ξi1 > 0 なら、平均から見て φ⃗1 の向きに近い。負なら反対向き。
ただし φ⃗1 と −φ⃗1 は同じPCで、scoreも同時に反転する。符号ではなく、平均±PCで実際の波形変化へ戻る。
Gmedの立脚初期活動が平均より高い人ほど、Gmaxの立脚後期活動は平均より低い傾向がある。
これは「この集団で観察された共同変動」の翻訳。筋間の因果や神経学的シナジーの証明ではない。
02.04 / implementation
実装の考え方は、各筋の波形をまず十分な数のFPCA scoreへ写し、そのscore群を共通の空間で統合すること。第2段階の重みづけを明示する。
import numpy as np
from sklearn.decomposition import PCA
from skfda import FDataGrid
from skfda.preprocessing.dim_reduction import FPCA

# each array: subjects × time, e.g. (26, 101)
time = np.linspace(0, 100, 101)

fd_gmed = FDataGrid(gmed, grid_points=time)
fd_gmax = FDataGrid(gmax, grid_points=time)

# stage 1: keep enough univariate PCs
fpca_gmed = FPCA(n_components=5)
fpca_gmax = FPCA(n_components=5)
gmed_scores = fpca_gmed.fit_transform(fd_gmed)
gmax_scores = fpca_gmax.fit_transform(fd_gmax)

# stage 2: put all muscle scores into one subject × feature matrix
Z = np.hstack([gmed_scores, gmax_scores])  # (26, 10)

# weighting must be chosen and reported explicitly
scale = Z.std(axis=0, ddof=1)
Z_weighted = Z / scale

mfpca = PCA(n_components=3)
joint_scores = mfpca.fit_transform(Z_weighted)  # (26, 3)
joint_loading_pc1 = mfpca.components_[0]第2段階のPC1が [0.6, 0.1, 0.0, −0.7, 0.2, 0.0] なら、Gmed側のstage-1 PC1〜3とGmax側のstage-1 PC1〜3を、その係数で組み合わせる。
| 筋 | stage-1 PC1 | PC2 | PC3 |
|---|---|---|---|
| Gmed | +0.6 | +0.1 | 0.0 |
| Gmax | −0.7 | +0.2 | 0.0 |
scoreの分散が大きい筋が第2段階を支配しないよう、総分散のそろえ方や重みを設計する。単純なscikit-learn PCAは、望んだ理論上のMFPCA weightingを自動では保証しない。
02.05 / read the result
単独の筋のPCを眺めてから筋を足すのではなく、全筋セットを一つの結果として読む。最後は必ずscoreから元波形へ戻る。
01 / RAW
Gmedだけでなく、GmaxやRFを重ねる。MFPCAが拾った共同変動が、実データのどの違いから出たのかを最初に把握する。
02 / MEAN VECTOR
平均はPCではない。 MFPCAでは μ⃗(t) として、筋ごとの基準線を並べて確認する。
03 / VARIANCE
PC1 45%、PC2 25%なら、複数筋を合わせた個人差の85%を3成分で説明する、という意味。重みづけで変わりうる。
04 / JOINT PC
Gmedが+の時間帯とGmaxが−の時間帯を同時に読む。片方だけ安定していても、共同PC全体が安定とは限らない。
05 / MEAN ± PC
μ⃗(t) ± aφ⃗k(t) を筋ごとに描き、PC scoreが高い人/低い人の具体的な波形差を言葉にする。
06 / SCORES + RECON
共通joint scoreを群・前後で比較し、保持PCで各筋を再構成する。score plotの見た目だけで結論を決めない。
「どの筋の、どの時間帯が、どの筋の、どの時間帯と、どちら向きに一緒に動くのか」を、共同PC関数と平均±PCから読む。
02 / chat Q&A
元チャットで実際につまずいた問いを出発点に、式・図・解釈を一段深くした。答えを先に読まず、まず自分の言葉で考えてから開く。
「2筋なら、Gmedのt1がこれ、t2がこれ…Gmaxのt1がこれ…という1点を作ると、あるタスクの特徴になるってこと?」
→ その理解でよい。ただし、その1点を全員分集めて、共同して変わる方向を探すのがMFPCA。
はい。 ただし1人の1タスクを1点にするだけで終わらず、全被験者の点を集めて「どの方向に散らばっているか」を探す。
この点は「Gmedの形」と「Gmaxの形」の組み合わせ全体。MFPCAのPC1は、たとえば Gmed立脚初期↑とGmax立脚後期↓が一緒に起きる方向を表す。
前半はよいが、後半は修正が必要。2筋で「一つの軸に潰れる」のではなく、二つの関数を束ねた直積空間を作る。
数学的には x⃗(t)=[xGmed(t),xGmax(t)]T というベクトル値関数。その巨大な空間で、MFPCAが一つの共同PC方向を見つける。
その理解でほぼ正確。 普通の2変数の共分散行列の各セルを、筋ペアの共分散面へ置き換える。
2筋×101時点なら各ブロックは101×101、全体は202×202。対角ブロックは筋内、非対角ブロックは筋間のcross-covariance。
それだけではない。 CGmed,Gmax(s,t) は、被験者間でGmedの時刻 s の偏差とGmaxの時刻 t の偏差が一緒に変わるかを表す。
正なら同じ向き、負なら逆向きの傾向。ただし時間的な因果、筋収縮の伝播、神経シナジーを証明する量ではない。
基本の考え方は逆。MFPCAでは、複数筋を含む共同共分散構造から一つの固有方向を求める。その後で、固有方向のGmed部分・Gmax部分を分けて表示する。
2段階法では実装上、各筋のFPCA scoreを連結して第2段階PCAを行うが、第2段階のloadingを各筋の固有関数へ戻して、最終的なPC関数セットとして解釈する。
共同PC方向への内積(投影)を取るから。Gmedの寄与とGmaxの寄与を足し合わせ、全筋セットとしてその方向にどれだけ近いかを1つに要約する。
筋ごとの曲線を捨てたのではなく、「この共同パターンをどれくらい持つか」という一つの座標へ投影している。
そのPCの向きを固定したとき、scoreが正の人は、正の φm,k(t) の時間帯で平均より高くなりやすい。負の時間帯では低くなりやすい。
前半が−、後半が+のような形は、活動ピークのタイミング差を表すこともある。ただし解釈は φ⃗(t) 単独で決めず、平均 ± PC と元波形で確認する。
固有関数の符号は任意。 φ⃗ と −φ⃗ は同じPCで、対応するscoreも反転すれば ξφ の再構成は同じ。
bootstrapやLOOの曲線を重ねる前に符号をそろえる。ソフトウェア間の+/−ではなく、平均±PCで実際の波形変化を合わせる。
説明分散は重要だが、それだけでは不十分。MFPCAでの説明率は複数筋セット全体の個人差に対する割合で、臨床的重要性や再現性を保証しない。
λ1≈λ2 ならPC番号が交換・混合しうるため、個々のPCではなくPC1–PC2が張る部分空間の安定性を確認する。
「どちらかが自動的に正しい」ではなく、結論がscalingに依存していることが結果。raw scale、総分散をそろえたscale、重みづけを並べ、研究質問に合う選択を事前に説明する。
設定を変えても同じ共同パターンが出るなら、解析条件に比較的依存しない頑健な所見と判断しやすい。
必ずしも捨ててよいとは言えない。単独の筋では小さいPC5でも、Gmax-PC2と強く共同変動する重要な情報かもしれない。一度捨てるとMFPCAには戻ってこない。
第1段階のPC数を3・5・8などで変え、joint PCの形、score、再構成がどう変わるかを感度分析する。
複数筋の共同差を知りたいなら、全対象者をまとめて共通MFPCA空間を作り、そのjoint scoreを群比較する。
before/afterは研究質問で選ぶ。全期間を共通空間へ置く、beforeだけで作ったbaseline空間へafterを投影する、差分波形 Δxi(t)=after−before にMFPCAする、の3通りがある。別々に学習したPC1 scoreの単純な引き算は避ける。
分かるのは、この集団で複数波形がどの組み合わせで共同して変動したか。因果、機序、神経学的シナジーはMFPCAだけでは結論できない。
「Gmed立脚初期↑とGmax立脚後期↓が同じPCに載った」という記述から、次の実験・生理学的仮説を作るところまでが安全な使い方。
02.06 / validity
説明分散が高いだけでは足りない。固有値、筋ごとのPC関数セット、被験者scoreが、対象者の入れ替えや設定の変更に耐えるかを見る。
01 / LOO
26人なら26回MFPCA。GmedだけでなくGmax・RFを含む PC関数セット全体 が保たれるか、外れた人が軸を支配していないかを見る。
02 / BOOTSTRAP
被験者を復元抽出して反復。曲線の帯やscoreの区間を確認する。重ねる前に符号をそろえ、符号反転を「不安定」と誤認しない。
03 / SCALING
raw scale、総分散をそろえたscale、basis数を変えて比較。Gmax優位から別の共同パターンへ変わるなら、その依存性を報告する。
04 / SUBSPACE
λ1≈λ2 ならPC1とPC2が交換・混合する。個々のラベルより、PC1–PC2が張る部分空間の安定性を比較する。
第1段階で各筋のPC1–3だけを残すと、捨てたGmed-PC5がGmax-PC2と共同していたとしても、MFPCAには永遠に出てこない。
単変量の説明分散が3%でも、MFPCAで重要とは限らないとは言えない。PC数を変えた感度分析を、妥当性評価の一部として残す。
Gmed・Gmaxは良好だがRFが悪いなら、上位MFPCA-PCがGmed+Gmaxの共同変動を優先し、RF固有の個人差を後ろのPCへ送っている可能性がある。
必ずしも失敗ではない。「RFは他筋とは独立した変動が多い」という構造かもしれない。筋ごとの再構成誤差を分けて報告する。
| 点検対象 | 見るもの | 不安定ならどうするか |
|---|---|---|
| 固有値・説明率 | 筋セット全体の分散、λの近さ、順位交換 | PC番号だけで解釈せず、部分空間を比較 |
| PC関数セット | 全筋の時間パターンと符号をそろえた重ね描き | Gmedだけでなく全筋セットで再評価 |
| joint score | LOO/bootstrapでscoreと群差が保たれるか | 外れ値、標本数、重みづけを確認 |
| 再構成 | 筋ごとの xim(t) と x̂im(t) | PC数を増やし、固有変動を後ろのPCまで確認 |
| 外れ値 | score plotの孤立点と元波形 | 測定ミス・artifact・正規化異常・真の戦略を切り分け |
02.07 / research design
MFPCAにも「唯一の正解の設計」はない。何を共同変動として説明したいかを先に決め、同じ物差しでscoreを比較する。
介入群と対照群をまとめてMFPCA。共同PC軸を共通にし、各対象者のjoint scoreを群間比較する。
beforeだけでMFPCAを学習し、afterを同じ空間へ投影。baselineの共同変動構造に対する移動として解釈する。
複数筋の差分波形 Δxi(t)=after−before を作り、その変化の共同パターンを分解する。
この集団では、複数の波形がどんな組み合わせで個人差を示すか。たとえば Gmed立脚初期↑ + Gmax立脚後期↓ + RF timing早期化 という「一緒の違い方」を、少数の軸へまとめられる。
なぜその共同変動が起きるか、神経学的シナジーがあるか、GmedがGmaxを変化させたかは分からない。MFPCAは 共変動構造 であり、因果・機序そのものではない。
02 / four choices
筋×時間、cross-covariance、共同PC、weighting、妥当性、研究設計まで。各問のあとに理由を表示して、用語ではなく構造を確認する。
12問。正解だけでなく、なぜその選択肢になるかを説明できるかを確認する。
正解 0/32 · 回答済み 0/32MFPCAは、複数波形の共同個人差を少数の軸へ要約する。因果や機序を自動で推定する方法ではない。
B各筋の101点を連結するので、2×101=202座標。これは1人のタスクの表現であり、主成分数が自動的に202になるという意味ではない。
C各ブロックは筋ペアの時間×時間共分散。2筋×101時点なら各ブロック101×101、全体は202×202になる。
Across-covarianceは筋間・時刻間の被験者間共変動。正負は同じ/逆向きの傾向を示すが、時間因果や同期の証明ではない。
Dφ⃗k(t)は一つの共同方向だが、解釈時にはφGmed,k(t)、φGmax,k(t)などのセットとして読む。
B各筋の寄与を共同PC方向への内積として合算するため、全筋セットの一つの座標になる。曲線を捨てたわけではない。
Cξφの積が同じなら、φとscoreを同時に−1倍しても結果は変わらない。bootstrapの重ね描き前に符号をそろえる。
A近い固有値では個々の軸のラベルが不安定になりうる。共同して張る部分空間を比較する方が頑健な場合がある。
DMFPCAはscaleやweightingで、どの筋の分散を重く見るかが変わる。結論の依存性そのものを透明に報告する。
B第1段階で捨てた情報は第2段階に戻せない。各筋3・5・8PCなどでjoint PCと再構成が安定するかを確かめる。
C比較したいものに応じて、全期間の共通軸、baselineへの投影、差分波形のMFPCAを選ぶ。別々の軸は向きや意味が変わりうる。
AMFPCAは観察された共変動構造を要約する。因果・神経制御機序を主張するには、別の研究設計と証拠が必要。
D9問以上に正解し、Q22の202次元、Q23のブロック構造、Q26のscore、Q29のscaling、Q31の研究設計を説明できれば、MFPCAの骨格をつかめている。
END / chapter 02
FPCAが1波形の個人差を読むなら、MFPCAは複数波形の「一緒の違い方」を読む。
01
2筋×101時点なら、筋と時間を連結した202次元の1点。
02
対角は筋内、非対角は筋間cross-covariance。
03
一つの共同方向を筋ごとのPC関数へ分けて読む。
04
scaling、第1段階PC数、符号、部分空間の安定性を記録する。
最後はいつも、joint score → 共同PC関数 → 平均±PC → 元の筋・時間帯、の順に戻って説明する。